
文章目录
- 科学原理导论
- 测试进度
- 前置条件与经过验证的安装方法
- 演示用户请求
- 演示数据
- 执行流程与关键逻辑
- 结果与产物
- 结果解释与实际扩展
- 失败防护、修复与替代方案
- 可复现性
- 局限性
- 参考文献
- 无需编程即可尝试此工作流
四位顾客分别在仿真时刻 0、1、2、3 到达一个容量为一的服务台,每次服务固定耗时两个时间单位。真实运行 SimPy 4.1.1 后,等待时间依次为 0、1、2、3,平均等待时间为 1.5,最大等待时间为 3,最后一位顾客在时刻 8 完成服务。以上数值已经通过原生程序执行、自然语言对话执行、CSV 结构检查以及独立语义校验。这个小型确定性案例既能人工逐项复核,又确实覆盖 Environment、Resource、生成器进程、资源请求和 timeout 等 SimPy 核心机制,因此适合作为离散事件仿真的可复现入门范例。
科学原理导论
离散事件仿真(discrete-event simulation,DES)把系统描述为一系列发生在离散时刻的状态变化。它不会像固定步长数值积分那样在每个微小时段更新所有状态,而是直接把仿真时钟推进到下一个已排程事件。对于排队服务、实验室设备共享、临床路径、生产线、交通运输、计算集群、故障维修和通信网络,重要变化通常由到达、开始服务、完成、失效或恢复触发,因此事件推进既自然又高效。SimPy 是以 Python 生成器为基础的进程式离散事件仿真框架,官方项目文档详细说明了环境、事件和进程之间的调度关系。
一个基本排队模型至少需要到达机制、服务机制、排队规则和资源容量。本例中的到达时刻和服务时长都是确定的,形式上接近有限时域的 D/D/1 队列:到达间隔确定、服务时间确定、服务台数量为一。不过,本例给出的是四个明确的到达时刻,并没有假设无限期稳定到达过程,因此不能把结果解释为稳态队列分布,也不能据此推断真实机构的长期服务水平。它的科学价值在于验证程序是否正确实现了概念模型,并用完全透明的事件轨迹解释等待时间如何形成。
SimPy 把活动实体写成 Python 生成器进程。进程向 Environment 交出一个事件,环境在该事件触发时恢复进程。容量为一的 Resource 代表服务台;顾客进程先等待到自己的到达时刻,再请求资源,获准后记录服务开始时刻,随后通过 env.timeout(2) 表示持续两个时间单位的服务。服务结束后释放资源,队列中的下一位顾客才可开始。这些调用不是为了装饰代码:测试明确要求真实执行这些机制,并拒绝仅凭算术预先写出结果表的替代实现。
当多个事件具有同一时间戳时,事件排序尤其值得注意。例如时刻 2 既是第一位顾客完成服务的时刻,也是第三位顾客的到达时刻。严谨的仿真需要说明调度语义,不能仅根据输出行的位置臆测因果。在本例中,资源占用区间清楚可核验:第一位顾客占用 [0,2],第二位占用 [2,4],第三位占用 [4,6],第四位占用 [6,8]。等待时间定义为服务开始时刻减去到达时刻;若要计算系统逗留时间,还需要加上服务持续时间。
仿真研究应严格区分验证与确认。验证(verification)关注程序是否正确实现预定模型;确认或有效性评估(validation)关注模型能否充分代表目标现实系统。本确定性案例具有很强的可验证性,因为每个时间戳都能手工推导。然而它没有任何真实诊所、仪器平台或工厂的观察数据,因此并未确认其对特定现实系统有效。软件测试通过不能被包装成运营预测,这一区分对负责任使用仿真结果至关重要。
真实项目通常包含随机性。分析人员需要根据数据或领域知识选择到达与服务分布,设置可追溯的随机种子,进行彼此独立的重复运行,并用置信区间而不是单条轨迹表达蒙特卡洛误差。对持续运行的系统,还需评估初始瞬态并决定预热期;对每天开门、关门的终止型系统,则应重现合理的每日初始状态。若拥堵属于罕见事件,可能需要更长仿真、方差缩减或重要性抽样。随机研究还应检查自相关,避免把高度相关的逐事件观察当成独立样本。
排队系统经常表现出非线性拥堵。当平均到达负荷接近服务能力时,工作量或波动性的小幅变化可能造成等待时间的大幅增加。然而,这种一般原理并不允许把本例的平均值外推到其他系统。一个“服务台”可以代表技术员、测序仪、显微镜、计算节点或样品制备工位;不同解释会引入班次、批处理、准备时间、故障、优先级、样品保质期和重做等机制。模型必须明确边界、单位、队列规则和忽略因素,并保留事件级证据,而不能只报告一个平均数。
本例之所以适合作为验证基准,是因为输入的服务需求速度高于单服务台的处理节奏:顾客每隔一个时间单位到达,但服务需要两个时间单位。第一位立即获得资源,此后队列逐渐积累,等待时间呈 0、1、2、3 的线性序列。这个规律能够发现资源容量设错、请求未等待、服务时长未生效、到达时刻处理错误、释放资源过早或最终时钟统计错误等常见缺陷。
从实验设计角度看,一个可信的离散事件模型应同时保留概念模型、可执行模型、输入数据、随机数控制、事件轨迹、汇总指标与校验规则。事件轨迹让审阅者追踪每个实体的状态变化,汇总指标便于比较不同方案,独立校验则避免报告逻辑与仿真逻辑共享同一错误。本次测试把 CSV 作为事件级事实,把 JSON 作为派生摘要,并逐项检查二者的一致性。
测试进度
| 测试关卡 | 实际状态 | 可核验证据 |
|---|---|---|
| 技能安装 | 通过 | 技能说明已进入智能体上下文 |
| 软件包安装 | 通过 | 托管环境保留 SimPy 4.1.1 |
| 演示数据 | 通过 | 四个明确到达时刻及固定服务时长 |
| 原生执行 | 通过 | 真实运行环境、资源、进程、请求与超时 |
| 对话执行 | 通过 | 自然语言请求生成全部指定交付物 |
| 产物校验 | 通过 | 事件行与摘要值均符合独立推导 |
| 文章准备 | 审阅中 | 科学测试通过,双语内容与媒体待发布审阅 |
本次有效证据来自第 3 次尝试。运行不需要 GPU、CUDA、在线服务或大型模型。按照保留环境的测试政策,软件包没有在成功后卸载,因此以后可以直接复核或修复,而不必反复下载。
前置条件与经过验证的安装方法
运行需要 Python 与 SimPy。本次在 Linux x86_64 CPU 环境中使用 SimPy 4.1.1。透明复现命令如下:
python -m pip install "simpy==4.1.1"
python native_demo.py --output-dir outputs
固定版本可以减少环境差异,但正式研究还应记录 Python 版本、操作系统、脚本校验和以及依赖锁文件。如果默认软件源连接失败,可以使用经过审核的镜像或保留的 wheel,并记录下载地址、散列值和版本;若解释器不兼容,应在独立环境中选择受支持的 Python,而不是修改系统解释器。无论采用哪种安装途径,都必须重新运行同一科学案例。只显示“安装成功”不会获得功能测试信用。
演示用户请求
使用已安装的 SimPy 技能及其保留环境,模拟四位顾客在时刻 0、1、2、3 到达一个容量为一的服务台,每次服务固定耗时两个时间单位。必须真实运行
simpy.Environment、simpy.Resource、进程、资源请求和 timeout。生成outputs/simpy-events.csv,包含 customer、arrival、service_start、departure、wait;同时生成outputs/simpy-summary.json,包含版本、顾客数、容量、服务时长、平均和最大等待时间、最终完成时刻。不得在未执行 SimPy 的情况下用算术表替代仿真。
这段请求同时规定了科学模型和证据契约。它防止执行者只返回一般性的排队论解释,也防止因为答案可手算而跳过被测试的软件包。自然语言输入是端到端测试的一部分,但结果是否可信仍由结构化产物和独立校验决定。
演示数据
输入是为确定性验证编制的合成数据,来源与限制记录在 data/README.md。时间使用抽象仿真单位;只有当研究者提供领域映射后,才能称为秒、分钟或小时。顾客编号只是实体标签,不包含个人信息,也不代表真实受试者。
| 顾客 | 到达 | 服务时长 | 容量 | 预期开始 | 预期离开 | 预期等待 |
|---|---|---|---|---|---|---|
| 1 | 0 | 2 | 1 | 0 | 2 | 0 |
| 2 | 1 | 2 | 1 | 2 | 4 | 1 |
| 3 | 2 | 2 | 1 | 4 | 6 | 2 |
| 4 | 3 | 2 | 1 | 6 | 8 | 3 |
数据规模刻意很小,以便人工逐项审计。它能够检验先进先出顺序、资源容量、服务占用、等待计算以及仿真结束时刻,但不能覆盖随机分布、优先级、抢占、中断、故障、弃排、容器、商店、实时仿真或置信区间。小数据不是生产负载基准,而是软件与科学语义的最小可辨识测试。
执行流程与关键逻辑
流程首先读取到达列表、容量和服务时间,然后构造一个环境与一个容量为一的资源。程序为每位顾客注册一个生成器进程。进程等待至到达时刻,请求资源,记录获准时刻,等待两个单位,记录离开时刻并释放资源。环境运行至所有事件结束后,程序按顾客顺序写出事件行,并从事件行计算摘要。
校验器不会相信报告中的自我声明。它读取 CSV,要求恰好四行及完整字段,核对服务开始为 0、2、4、6,离开为 2、4、6、8,等待为 0、1、2、3;随后核对 JSON 中的软件版本、顾客数、容量、服务时长、平均等待、最大等待和最终时间。事件级文件与摘要文件相互约束,能够发现复制、转写、排序和聚合错误。
一项更完整的研究可以在此基础上增加可配置输入。到达过程可能来自经验分布、非齐次泊松过程或预约表,服务时间可能按任务类型分层,资源可能具有班次与停机日历,队列规则也可能包含优先级和截止时间。每增加一个机制,都应新增能区分正确与错误实现的测试,而不是仅增加代码复杂度。
结果与产物
主要结果是平均等待 1.5 个仿真时间单位,最大等待 3 个时间单位,全部服务在时刻 8 完成。由于输入不含随机变量,这些值对当前有限事件表是精确值,不存在抽样标准误;但“无抽样不确定性”绝不等于对真实系统有确定预测。
事件轨迹保存在 simpy-events.csv,机器可读摘要保存在 simpy-summary.json,审阅报告保存在 results-report.md。
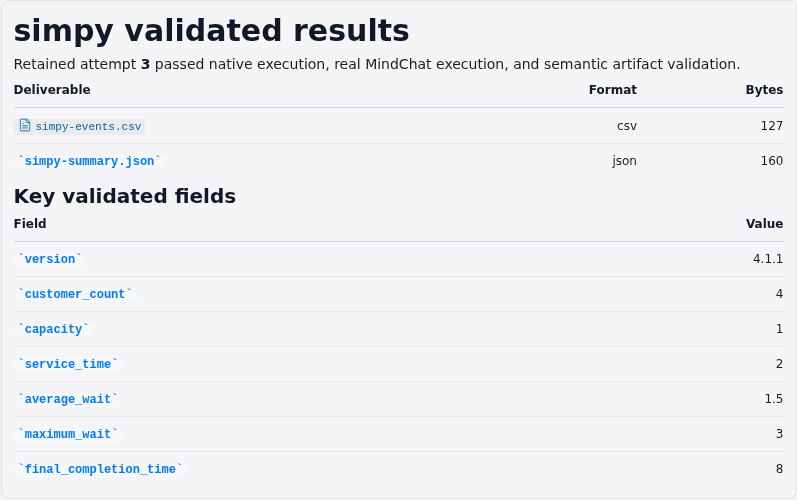
该截图展示的是经过验证的结果报告,而不是文件列表或原始 JSON 编辑器。它证明自然语言驱动流程把科学结果呈现给了用户,但科学计算信用仍来自原生执行和结构化产物。
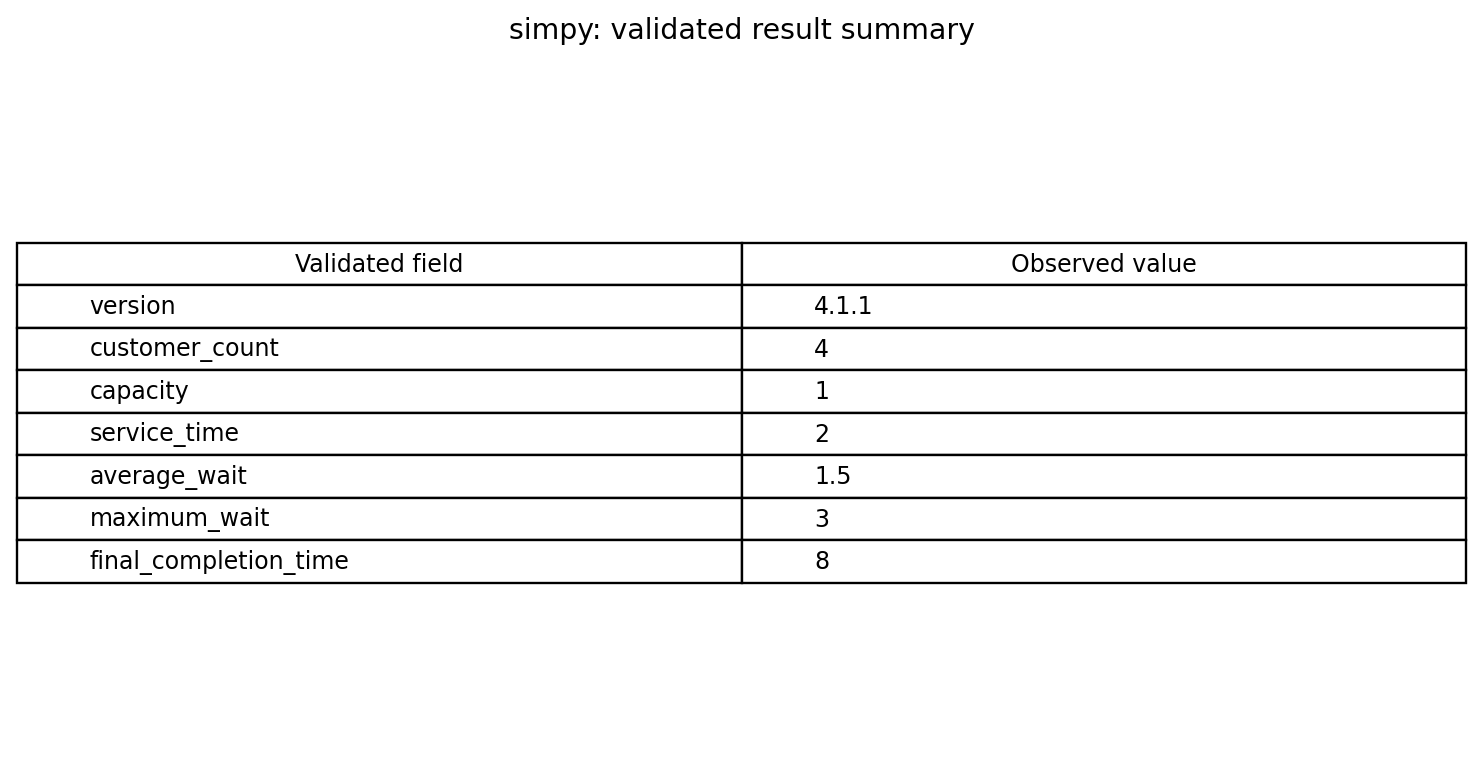
表格清楚呈现事件因果顺序。到达间隔为一而服务耗时为二,因此在短时域内队列增长,每位后续顾客比前一位多等待一个单位。
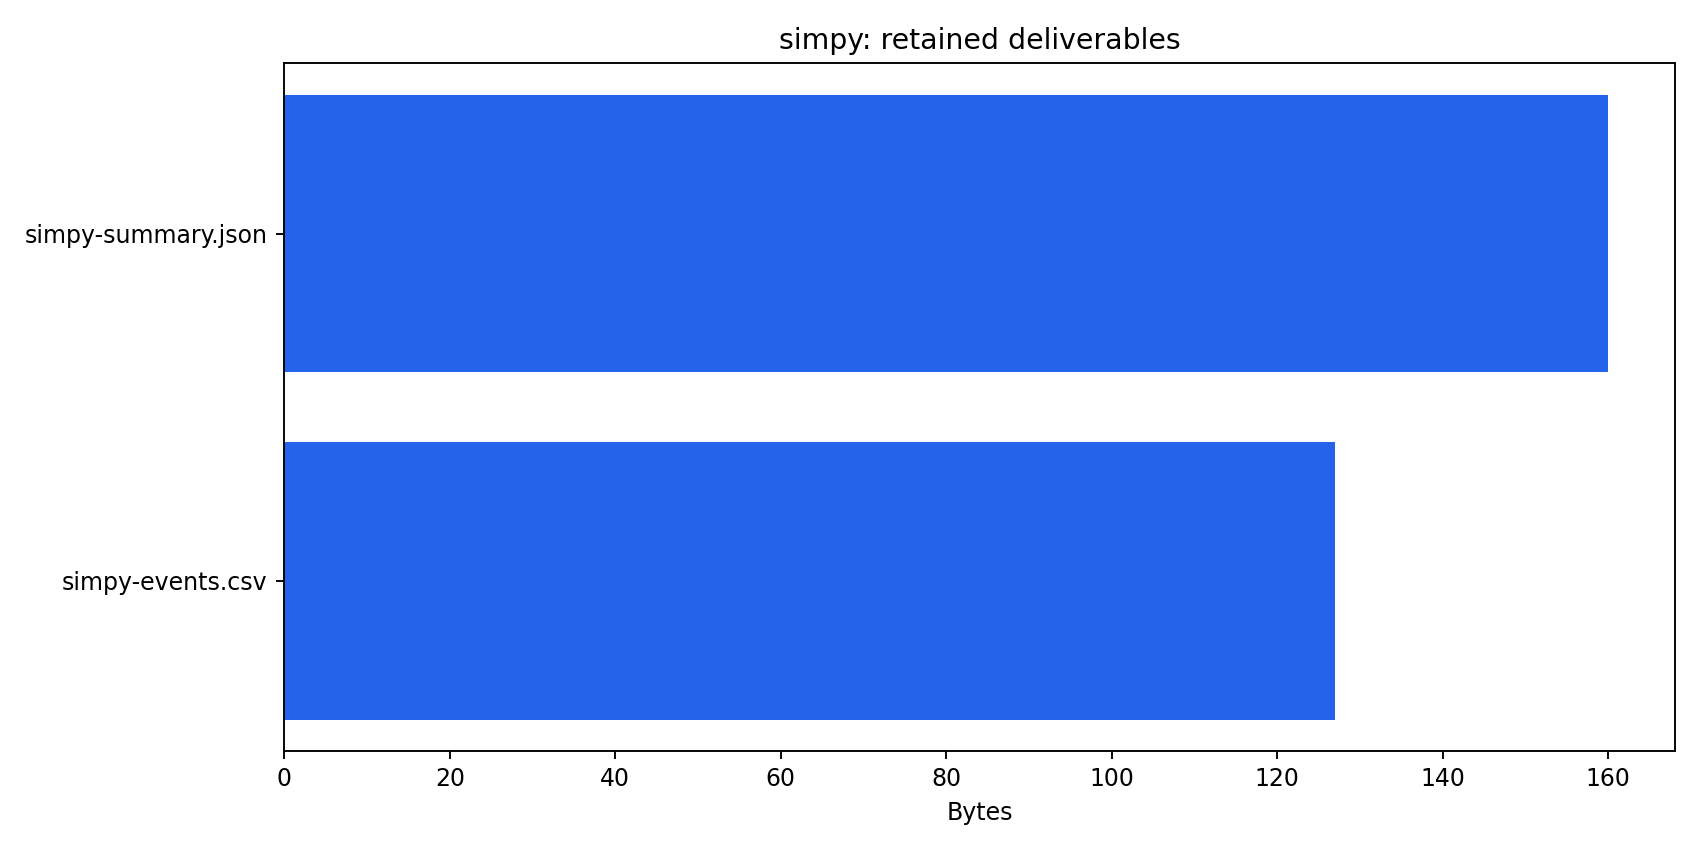
产物清单说明事件数据、摘要和可读报告均已保留。仅有文件并不代表成功;文件还必须非空、结构正确、数值一致并与请求相符。
结果解释与实际扩展
第一位顾客到达时资源空闲,所以立即开始。第二位在第一位服务期间到达,等待一个单位;第三位虽然在第一位完成的时刻到达,但第二位已经按队列顺序等待,因此第三位等待两个单位;第四位等待三个单位。平均值由 (0+1+2+3)/4 得到 1.5,最后一个两单位服务区间在时刻 8 结束。
若用于容量规划,下一步不应只改变一个平均值,而应建立对比场景:增加服务台、改变服务时长波动、引入高峰到达、设置优先规则或加入设备停机。除了平均等待,还应报告等待分位数、超过服务水平阈值的概率、时间加权队列长度、资源利用率、吞吐量和成本。平均数可能掩盖尾部风险,尤其在医疗、样品稳定性或服务承诺场景。
模型确认需要真实数据。可以把观察到的到达间隔、服务时间、队长和日终未完成量与仿真分布比较,使用留出时段检查外部有效性,并让领域专家审查流程逻辑。参数校准与模型验证最好分离,避免用同一数据既拟合又宣称预测成功。对决策敏感的假设应进行全局或情景敏感性分析。
失败防护、修复与替代方案
本测试最重要的防护是要求软件包特异性执行。由于结果容易手算,一个脚本完全可能跳过 SimPy 并直接写出期待数字,从而造成虚假通过。最终契约明确要求环境、资源、生成器进程、请求和超时,原生演示也确实导入并运行安装的软件包。语义校验再验证事件轨迹,而不是只检查进程退出码。
如果包安装失败,应先保留完整错误、Python 版本和平台信息。网络故障可通过受控镜像或缓存 wheel 修复;编译或解释器不兼容可通过作用域隔离环境处理。任何替代安装都必须执行相同用例。电子表格、手写事件循环、模拟模块或仅生成报告的脚本可以用于比较,却不能替代本次 SimPy 功能验证。
对于模型错误,修复不能只改文章。例如等待列单位不一致、资源容量被忽略或同时间戳顺序导致结果变化时,应保存失败产物,定位模型或提示说明的缺陷,修改技能说明及脚本,再用完全相同的用户请求重跑。只有重新生成的结构化产物通过检查,文章才可更新为通过状态。
可复现性
有效运行标识为 attempt 3;平台为 Linux x86_64;加速器为 CPU;核心软件为 SimPy 4.1.1;最近验证日期为 2026 年 7 月。输入说明、源脚本、自然语言请求、CSV、JSON、结果报告、截图元数据和散列值都保存在同一测试档案中。截图清单记录 Playwright、对话路由、聚焦定位器和来源产物;视觉清单把每张图追溯到对应数据。
复现时应以结构化输出和语义断言为权威,不应依赖像素截图。截图用于快速人工审阅和文章呈现;CSV 与 JSON 才支持机器比较。正式研究还应记录系统时区、区域设置、完整依赖锁、脚本提交版本、随机种子策略和每次重复运行的标识。
由于本例确定性且规模固定,同版本重复运行应给出完全相同的数值。若出现差异,应首先检查输入、资源容量、队列规则和同时间戳事件逻辑,而不是用容差掩盖。若扩展为随机模型,则应比较分布与置信区间,而不是要求每条轨迹逐字节相同。
局限性
本测试只覆盖确定性、非抢占、先进先出、单容量资源。它没有验证随机采样、种子复现、优先资源、抢占式资源、弃排、超时取消、故障中断、Store、Container、实时环境或分布式运行,也没有测量大规模事件下的性能。没有经验数据,所以它不是任何现实排队系统的有效性证明。
平均等待 1.5 只能用于这个输入。改变任一到达时刻、服务时长、队列纪律或容量都会改变轨迹。确定性输入没有统计误差,但模型结构仍存在不确定性。领域应用需要数据质量评估、专家审查、校准、确认、敏感性分析和与决策风险匹配的不确定性报告。
本例也未比较解析排队论与仿真估计。对于具有经典稳态假设的简单队列,解析公式可能更高效;仿真的优势在于表示复杂流程、非平稳到达、资源共享和业务规则。方法选择应由问题结构决定,而不是因为工具易用就默认仿真。
参考文献
- SimPy 项目:SimPy 进程式离散事件仿真官方文档。
- SimPy 项目:共享资源、资源请求与队列机制专题指南。
- Banks J、Carson JS、Nelson BL、Nicol DM:Discrete-Event System Simulation。
- Law AM:Simulation Modeling and Analysis。
- Kendall DG:Stochastic processes occurring in the theory of queues and their analysis by the method of the imbedded Markov chain。
无需编程即可尝试此工作流
MindPlot 已内置对上述 SimPy 技能的支持。用户只需用自然语言描述到达、服务与资源条件,MindPlot 智能体就会根据技能编写并运行包特异性代码、保留 CSV 和 JSON,并呈现经过验证的结果,因此无需亲自编写本文中的复现代码。可以访问 https://mindplot.ai 在线尝试,或下载桌面版本,以获得更完整的交互体验和更强的本地数据隐私保护。