
文章目录
- 科学原理导论
- SHAP 值究竟表示什么
- 数据、划分与模型合同
- 先评价预测,再解释预测
- 全局平均绝对重要性
- 蜂群图中的方向与分布
- 依赖图的正确阅读
- 局部瀑布解释
- 测试进度
- 演示用户请求
- 演示数据
- 结果与产物
- 可加性与数值验证
- 负责任的解释边界
- 可复现性
- 进一步分析建议
- 常见失败方式
- 局限性
- 参考文献
- 无需编程即可尝试此工作流
科学原理导论
预测模型可能具有不错的精度,却仍然难以审查。随机森林把许多决策树的结果取平均,每棵树又包含不同变量、阈值与交互关系,因此阅读一棵树不能代表整个模型。模型解释方法处理的是一个比因果科学更窄的问题:在已经拟合的预测函数和明确的参考约定下,怎样把某一次预测相对于基线的变化分配给输入特征?SHAP 以合作博弈论中的 Shapley 值为基础,为这个问题提供统一的数学框架。
在合作博弈中,不同参与者共同产生收益;在模型解释中,特征被视作参与者,模型预测相对参考值的差异被视作收益。一个观测的每个 SHAP 值都是带方向的贡献:正值把预测推向高于基线的位置,负值把预测推向低于基线的位置。所有贡献与期望输出相加,应当重建被解释的模型预测。这种局部准确性很重要,但它不会把统计关联转化为因果效应,也不会证明模型学到的规律在科学上正确。
本文记录一次真实保留的 Linux x86_64 CPU 验证。工作流安装并调用 SHAP 0.52.0,使用 scikit-learn 公共糖尿病回归教学数据与 RandomForestRegressor。智能体依据自然语言请求读取夹具、编写分析程序、拟合模型、评估固定留出集、使用真实 shap.TreeExplainer 解释 64 个未见样本、验证数值可加性、排序全局平均绝对贡献,并生成四类互补图形。
这是软件功能与工作流验证,不是临床研究。数据集虽源于疾病进展研究,但在此仅作为公开回归教学材料。结果不能用于诊断、治疗选择、患者风险判断或生物机制推断。图中显示的是一个特定模型如何利用输入变量,不是干预某变量将如何改变患者结局。
SHAP 值究竟表示什么
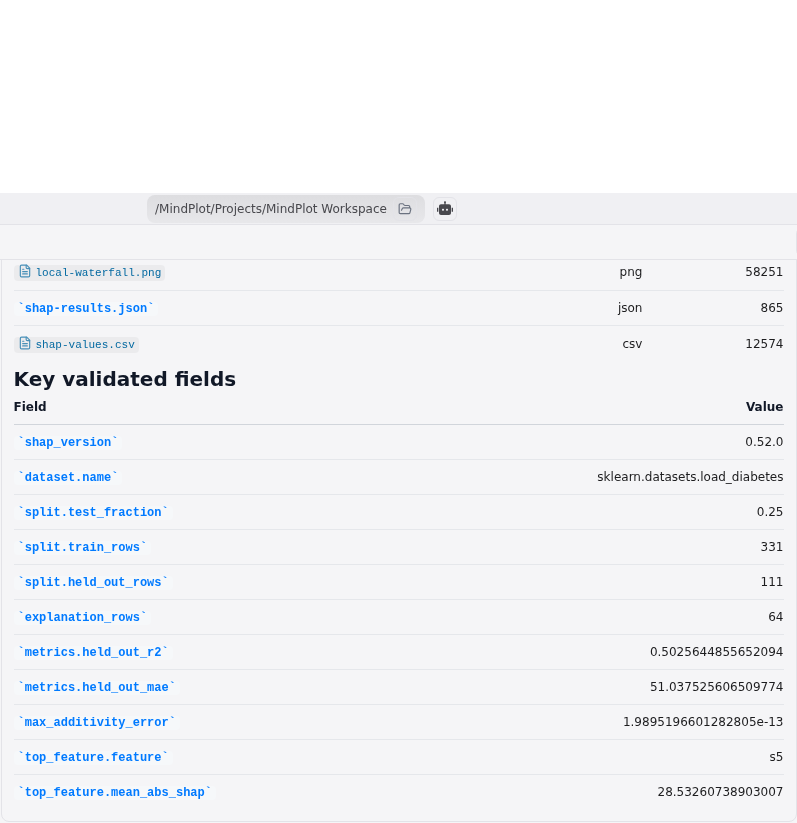
对一个观测,TreeExplainer 为每个特征返回一个贡献值。贡献的单位与模型输出一致。把解释器期望值与所有贡献相加,应该得到该观测的模型预测。第 5 次通过尝试中,64 个解释样本的最大绝对重建误差为 1.9895196601282805e-13,远低于规定的 1e-8。这说明解释数组、特征顺序、样本顺序与模型输出在数值上相互对应。
局部贡献依赖训练好的模型、预处理方式、特征编码和解释器关于缺失特征的约定。如果模型学到偏差或数据泄漏,SHAP 可以非常准确地解释这个错误模型,却不能替它纠正问题。当两个变量高度相关时,归因可能在二者之间重新分配;换一种背景数据或依赖假设,数值也可能改变。因此,解释必须同时声明拟合对象与条件。
平均绝对 SHAP 值把多个样本的局部贡献幅度取平均,用来回答“在所选解释样本中,哪些输入对模型输出改变得最多”。绝对值会丢失方向:一个变量在部分样本中强烈增加预测、在另一些样本中强烈降低预测,仍可能排名靠前。它也不是删除变量后的性能损失,更不是因果效应量。
数据、划分与模型合同
演示输入是 diabetes-explanation.json。文件明确指定 sklearn.datasets.load_diabetes、随机种子 20260727、25% 测试比例、120 棵树且最大深度为 5 的 RandomForestRegressor,以及用于解释的前 64 个留出样本。把这些条件写成机器可读数据,可以阻止执行者为了得到漂亮结果而悄悄更换模型或样本。
源数据共有 442 行、10 个标准化预测变量,包括年龄、性别、体质指数、血压以及六个以 s1 至 s6 命名的血清测量。固定划分产生 331 个训练样本与 111 个留出样本。模型只在训练分区拟合,解释使用留出分区中的 64 行,因此图形描述的是模型面对未见样本时的行为,而不是训练记忆。
随机森林通过平均许多去相关回归树表达非线性和交互。最大深度 5 限制单树复杂度,120 棵树降低集成随机波动。这些参数只是演示合同,不是通用最优值。生产分析应该把超参数选择放在训练数据内部,并用嵌套或独立验证避免选择偏差。
先评价预测,再解释预测
解释不能替代模型评价。对 111 个留出样本,本次模型的 R² 为 0.5025644855652094,平均绝对误差为 51.037525606509774。R² 相对于“始终预测留出目标均值”的平方误差基线衡量拟合;约 0.503 表明这个固定模型在该划分下解释了约一半留出方差。MAE 表示预测与真实目标之间绝对差异的平均值。
这两个指标不能证明临床效用。严谨应用还需要重复或嵌套重采样、置信区间、简单基线比较、残差诊断、适用时的校准、亚组表现、时间或外部验证,并评估预测目标是否支持真实决策。这里的指标只说明得到一个非平凡预测函数,足以检验解释 API。
解释质量与预测质量彼此独立。可加性完全通过的 SHAP 值也可能精确解释一个很差的模型;高性能模型也可能因为背景数据、输出列、特征映射或变换列选择错误而被误解。因此工作流同时保存性能指标与可加性诊断,不允许只凭归因图片宣布成功。
全局平均绝对重要性
全局条形图对 64 个解释样本的平均绝对 SHAP 值排序。排名第一的是 s5,数值为 28.53260738903007;其次是 bmi,为 18.77411848596093;第三是 bp,为 8.68982882122211。其余依次为 s3 3.89414、s6 3.52555、s2 2.26608、age 2.08161、s4 1.80769、s1 1.26695 与 sex 0.86167。
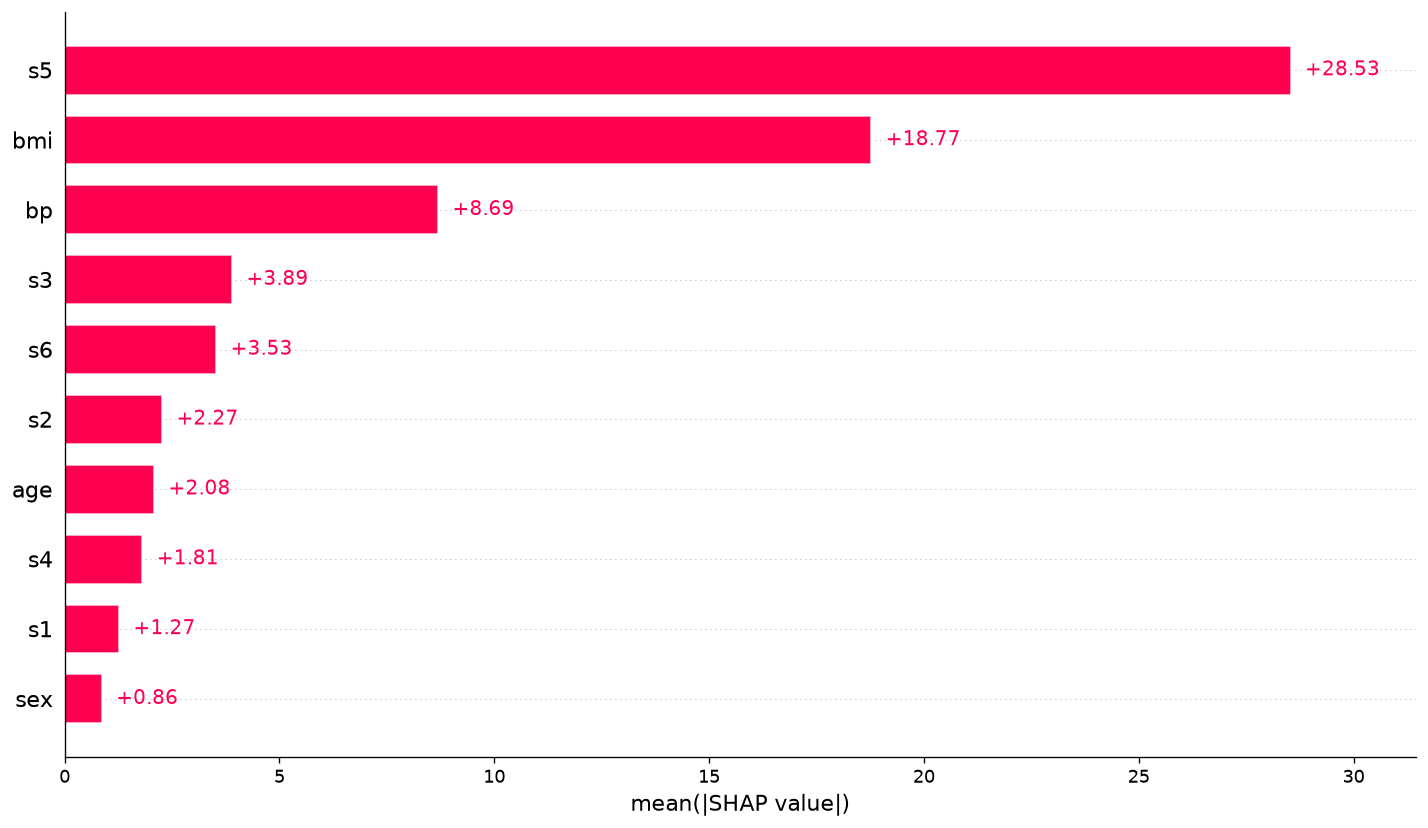
这个排序只概括当前模型、当前划分与当前解释子集。它绝不表示把 s5 改变一个单位会使结局因果变化 28.53。血清测量可能相关,特征已经标准化,森林也可能在不同分裂中分配相关信号。对多个重采样重复计算,才能观察排序是否稳定。
蜂群图中的方向与分布
蜂群图保留条形图丢失的信息。每个点代表一个样本在一个特征上的归因,横坐标为带符号 SHAP 值,颜色编码该样本的对应特征值。密集区域表示常见贡献,长尾提示少数有影响的样本;高低取值同时出现在正负两侧时,可能提示非线性、交互或相关结构。
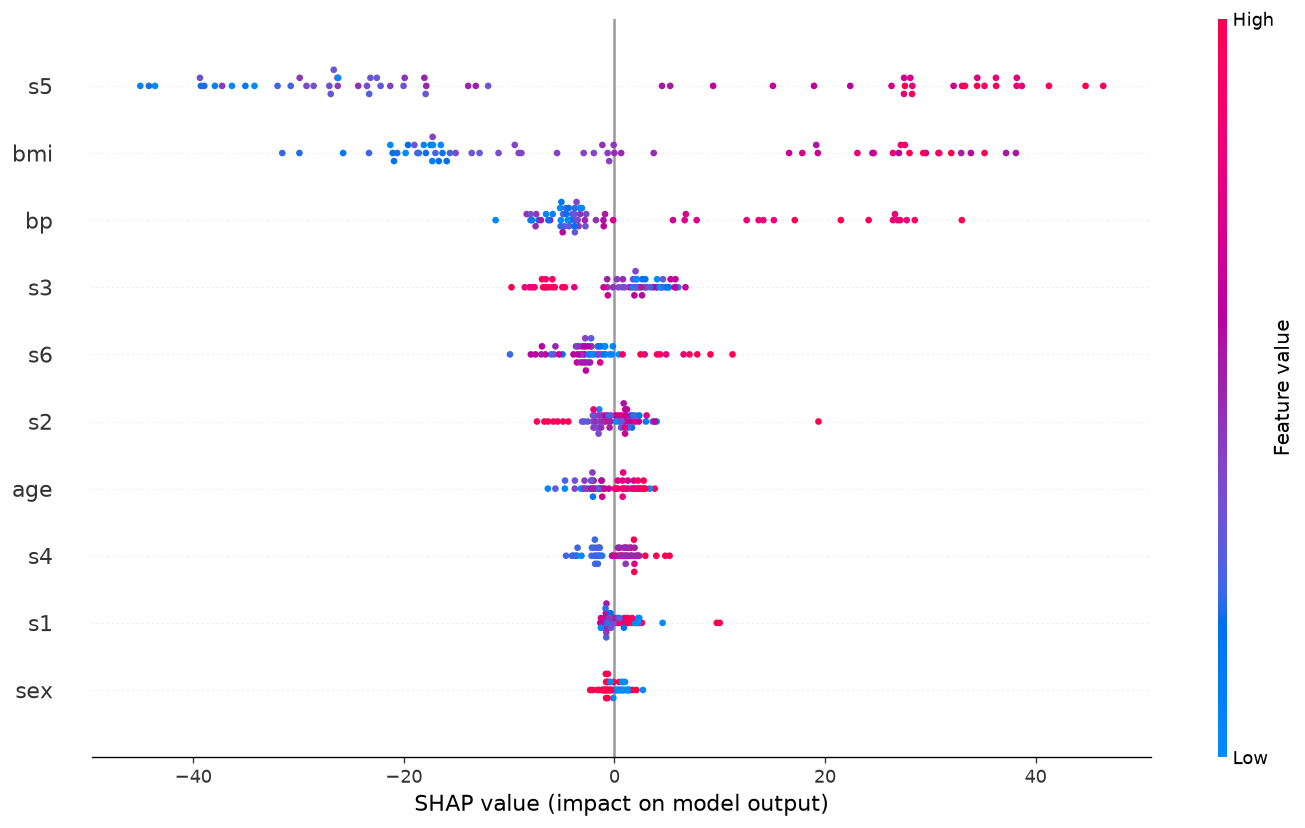
颜色模式只能表述拟合森林的关联行为。如果高取值的红点集中在正侧,只能说模型倾向于把这些高取值同较高预测联系起来。混杂、选择机制、测量误差与相关变量都可能产生相同图案,而不要求真实干预效应存在。
依赖图的正确阅读
依赖图把一个特征的观测值放在横轴,把该特征对预测的 SHAP 贡献放在纵轴。它有助于发现模型中的阈值、饱和、非单调关系和可能由交互引起的纵向离散。本次程序根据计算出的全局表选择首位特征,而不是预先硬编码一个更容易讲故事的变量。
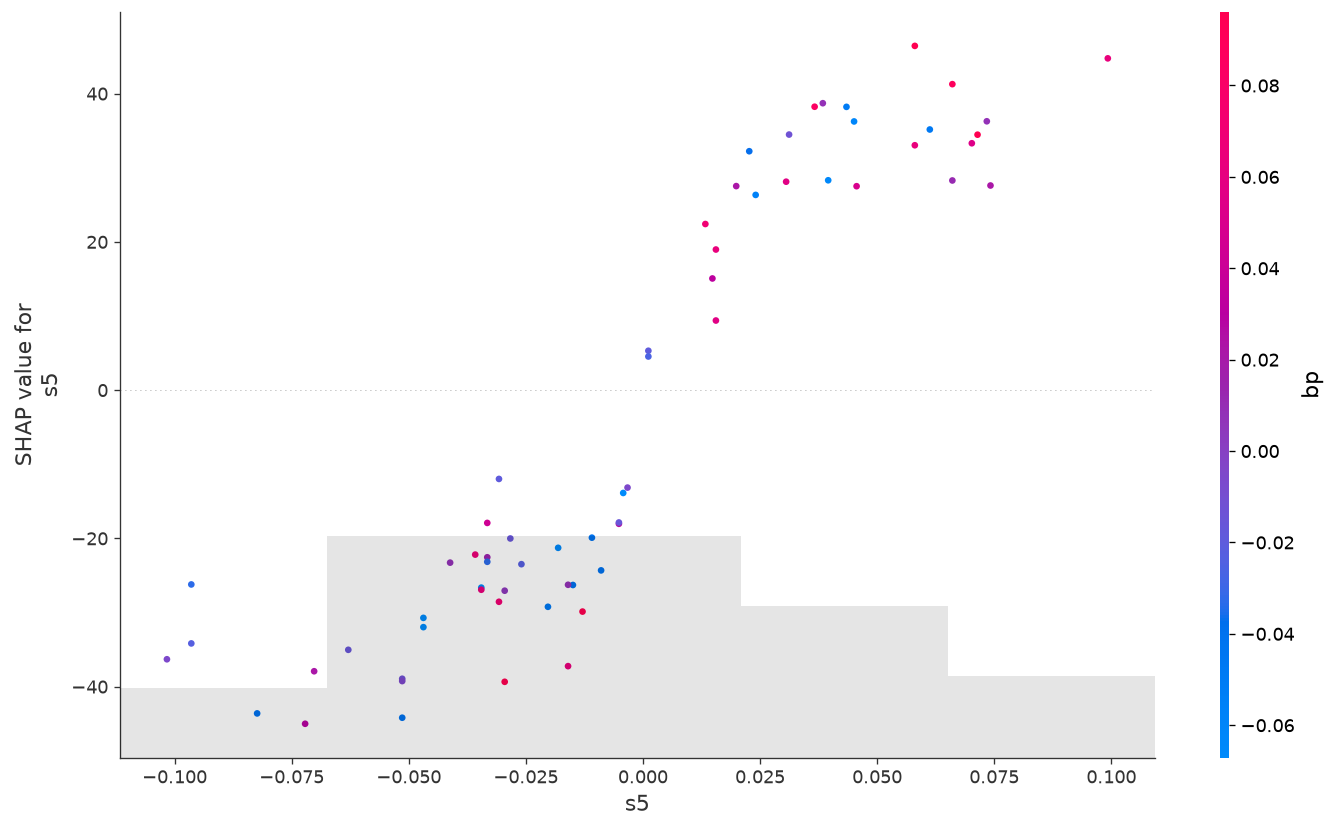
依赖图不是部分依赖估计,更不是干预曲线。横轴覆盖范围受现有样本限制,纵轴归因也依赖其他特征。数据稀疏区不能支持强结论。面对相关临床变量时,可以补充累积局部效应、条件期望方法、敏感性分析与专业审阅。
局部瀑布解释
全局摘要可能掩盖单个样本。瀑布图从模型期望输出出发,逐项显示不同特征如何把一个选定观测的预测向上或向下推动,直到最终输出。它适合审计异常预测、核对特征映射,并清楚区分总体基线和个体贡献。
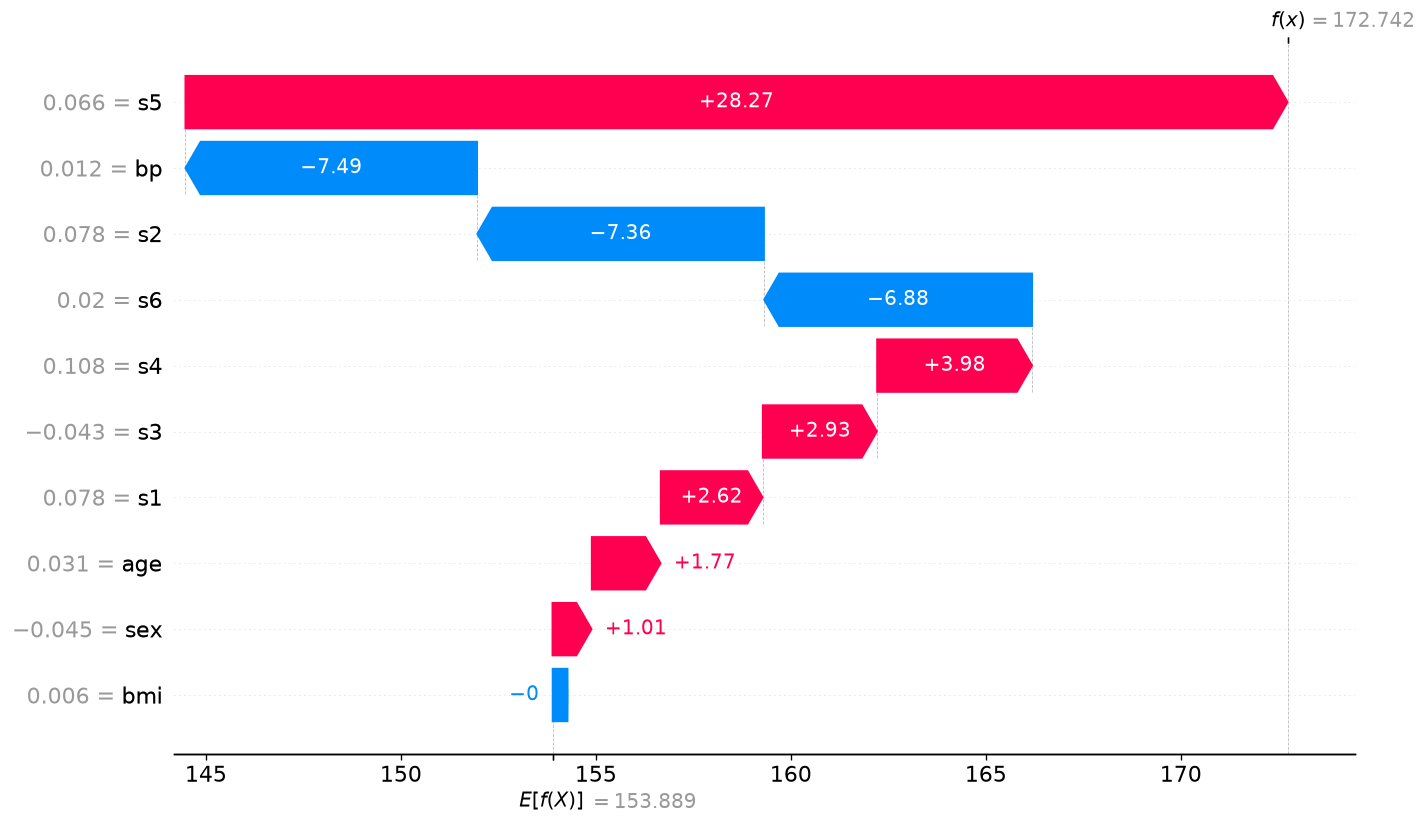
一个局部解释不能代表全部样本。如果研究者先看结果再挑最戏剧化案例,会产生选择偏差。生产报告应预先定义选例规则,同时检查正确预测、错误预测、边界样本和离群值,并避免暴露敏感的行级信息。
测试进度
| 验证门槛 | 状态 | 保留证据 |
|---|---|---|
| 软件包安装 | 通过 | Linux CPU 环境中的 SHAP 0.52.0 |
| 原生关键功能 | 通过 | 森林、TreeExplainer、性能、可加性、CSV、JSON 与 PNG |
| 真实聊天执行 | 通过 | 第 5 次尝试生成全部精确交付物 |
| 数据与划分 | 通过 | 442×10;331 个训练、111 个留出 |
| 解释样本 | 通过 | 64 个未见观测 |
| 可加性 | 通过 | 最大误差 1.9895196601282805e-13 |
| 图形合同 | 通过 | 四张不同科学结果图 |
| 聚焦界面证据 | 通过 | Playwright 结果报告截图 |
五次保留尝试体现真实反馈闭环。早期尝试暴露文件命名与结果字段合同的歧义,没有被改写成“通过”。只有第 5 次同时满足精确文件、科学语义与验证要求后才进入出版。仅仅成功导入软件包、生成任意图片或返回一段文字,都不构成功能通过。
演示用户请求
使用已安装的 SHAP 技能和保留 Python 环境分析
diabetes-explanation.json。加载真实 scikit-learn 糖尿病教学数据,在固定划分上拟合声明的 RandomForestRegressor,并使用真实shap.TreeExplainer解释前 64 个留出样本。对照模型预测验证 SHAP 可加性,计算留出 R² 与 MAE,按全局平均绝对 SHAP 排序,生成全局条形图、蜂群图、依赖图和一个样本的瀑布图,并严格保存指定 JSON、CSV 与 PNG。只能把 SHAP 值描述为拟合预测函数的解释,不能描述为因果效应、生物机制或临床证据。
这是包含目标、限制、输入、检查与交付物的自然语言请求,不是把答案硬编码到脚本。端到端测试中,智能体阅读技能与夹具,编写分析程序,在受管环境执行并检查输出。用户无需编写 Python;下面的命令仅用于审计和复现。
演示数据
链接夹具 diabetes-explanation.json 保存随机种子、数据标识、划分比例、模型类别与参数、解释行数以及解释范围。它不包含预计算 SHAP 数组,也不包含预期特征排名,因此结果必须来自真实拟合模型。
| 夹具字段 | 声明值 | 作用 |
|---|---|---|
| 随机种子 | 20260727 | 复现划分与模型随机性 |
| 数据集 | sklearn diabetes | 公开回归教学数据 |
| 测试比例 | 0.25 | 保留独立性能评价 |
| 树数 / 深度 | 120 / 5 | 定义拟合森林 |
| 解释行数 | 64 | 约束并标识归因样本 |
~/.mindplot/envs/skill-shap/bin/python analyze_shap.py
生成程序读取夹具、训练估计器、调用 shap.TreeExplainer、计算预测与归因矩阵、验证重建,并渲染出版尺寸图片。保留的程序和输出可以审查智能体究竟运行了什么。
结果与产物
| 结果 | 精确观测值 | 科学解释 |
|---|---|---|
| SHAP 版本 | 0.52.0 | 明确 API 与复现边界 |
| 数据形状 | 442×10 | 完整公共教学矩阵 |
| 训练 / 留出 | 331 / 111 | 固定 75/25 划分 |
| 解释观测 | 64 | 用于归因摘要的子集 |
| 留出 R² | 0.5025644855652094 | 当前划分的中等预测拟合 |
| 留出 MAE | 51.037525606509774 | 目标单位内平均绝对误差 |
| 首位特征 | s5 | 平均绝对归因最高 |
| 首位平均绝对 SHAP | 28.53260738903007 | 模型输出单位,不是因果效应 |
| 最大可加性误差 | 1.9895196601282805e-13 | 数值重建通过 |
shap-results.json 保存版本、维度、性能、诊断和范围;global-importance.csv 使完整排序可检查;shap-values.csv 为每个解释观测保留一行、每个特征保留一列,并包含源行索引。四张 PNG 分别呈现全局幅度、带符号分布、特征依赖和局部解释。
可加性与数值验证
对每个解释行,验证器比较森林预测与“期望值加全部 SHAP 贡献之和”。最大绝对差约为两万亿分之一,符合浮点舍入范围。这项检查可以发现解释了错误行、转置贡献矩阵、遗漏列或混用不同模型输出等常见错误。
可加性不会验证因果解释、数据质量、泛化能力或公平性。它只说明解释数组重建了所代表的模型输出。因此流程还同时验证数据形状、版本、划分计数、性能指标、CSV 内容、图片尺寸和范围声明。
负责任的解释边界
SHAP 继承数据与模型的全部限制。遗漏变量可能让现有特征替代未测因素,相关性可能让归因不稳定,数据泄漏可能产生看似可信但完全无效的解释,选择偏差可能阻止模型迁移到其他人群,受保护属性也可能被代理变量间接编码。
在业务或科研应用前,分析者应定义决策问题、潜在伤害、评价人群、可接受错误与人工复核程序。应比较不同重采样与模型家族的解释,检查亚组性能和归因分布,测试背景数据与依赖假设的敏感性,并编写清楚说明预期用途、禁止用途、训练时期、预处理和监测边界的模型卡。
临床解释需要更高等级证据,包括前瞻评价、代表性队列、校准、不确定性、伦理与监管审查,以及使用模型确实改善结局的证明。本教学运行不具备这些条件,只验证解释工具能够被可复现地执行。
可复现性
完整复现需要输入夹具、源数据版本、训练测试索引或确定性种子、估计器参数、软件版本、解释样本选择、特征顺序、解释器配置和产物校验和。单张截图不能构成可复现证据。本轮保留生成程序、JSON、两张 CSV 表、四张结果图、日志和语义验证报告。
软件升级可能改变树行为、绘图默认值、序列化或数值输出。未来升级必须重跑完整原生与聊天功能循环,不能凭一次导入成功推断兼容。此次只验证 Linux x86_64 CPU;macOS、Windows、ARM、CUDA 与其他版本需要各自证据。
进一步分析建议
可以通过多次重复划分或交叉验证研究重要性排序稳定性,并报告每个特征平均绝对归因的分布,而不是只给单一数字。可以将随机森林与线性模型、梯度提升和简单基线比较,判断结论是否依赖模型类别。对强相关特征,可以做分组归因或条件敏感性分析。
还应检查残差随目标和特征的变化、极端预测、训练与测试分布差异,以及解释样本是否覆盖完整留出集。若模型进入决策流程,需要连续监测输入漂移、性能退化与解释模式突变。解释工具最有价值的用途之一,是帮助发现不合理依赖并触发进一步调查,而不是替模型提供自动可信证明。
常见失败方式
常见错误包括对训练数据而非留出数据作图、解释一个估计器却报告另一个估计器的指标、在预处理后丢失特征名、把分类输出维度当成回归数组、只检查文件存在而不检查数值,以及把平均绝对重要性描述成方向效应。本次合同通过精确行数、形状、指标和可加性约束减少这些风险。
另一个错误是把漂亮图形当作科学结论。蜂群颜色、依赖曲线和瀑布箭头都容易诱发因果叙事。报告必须反复说明其对象是拟合预测函数,并把数据产生过程、未测混杂、相关性、外部有效性与决策风险放回解释中。
局限性
案例样本较小,只使用一个历史教学数据集、一次随机划分、一类估计器和一组固定超参数。解释子集只有 64 行。没有重复交叉验证、外部队列、时间验证、缺失数据压力测试、亚组审计、超参数选择分析、不确定区间或其他解释器比较。
s1 至 s6 是刻意去标识的短名称,不能凭猜测赋予生物学含义。平均绝对归因丢失方向,依赖图形状可能反映交互或相关,瀑布图只代表一个样本。R² 与 MAE 不建立临床效用。全部结果解释模型预测,而不是疾病机制、干预效果或个体预后。
参考文献
- Lundberg 与 Lee:A Unified Approach to Interpreting Model Predictions
- Lundberg 等:From local explanations to global understanding with explainable AI for trees
- SHAP TreeExplainer 官方文档
- scikit-learn 糖尿病数据集文档
- Interpretable Machine Learning:SHAP 章节
无需编程即可尝试此工作流
MindPlot 内置支持这一科学工作流。上传表格数据或用自然语言描述拟合模型解释任务,智能体可以编写并运行分析、保留数值表格与图形、验证交付物并说明负责任使用边界。可在 mindplot.ai 在线尝试,或下载桌面版获得更强的本地数据隐私保护。